11. desember lanserte språkteknologigruppen (LTG) ved Universitetet i Oslo NorMistral-11B-thinking – den mest avanserte store språkmodellen (LLMen) i NorMistral-familien av åpne, norske modeller. Modellen er tilgjengelig for nedlasting under åpen Apache-2.0-lisens (som tillater kommersiell bruk).
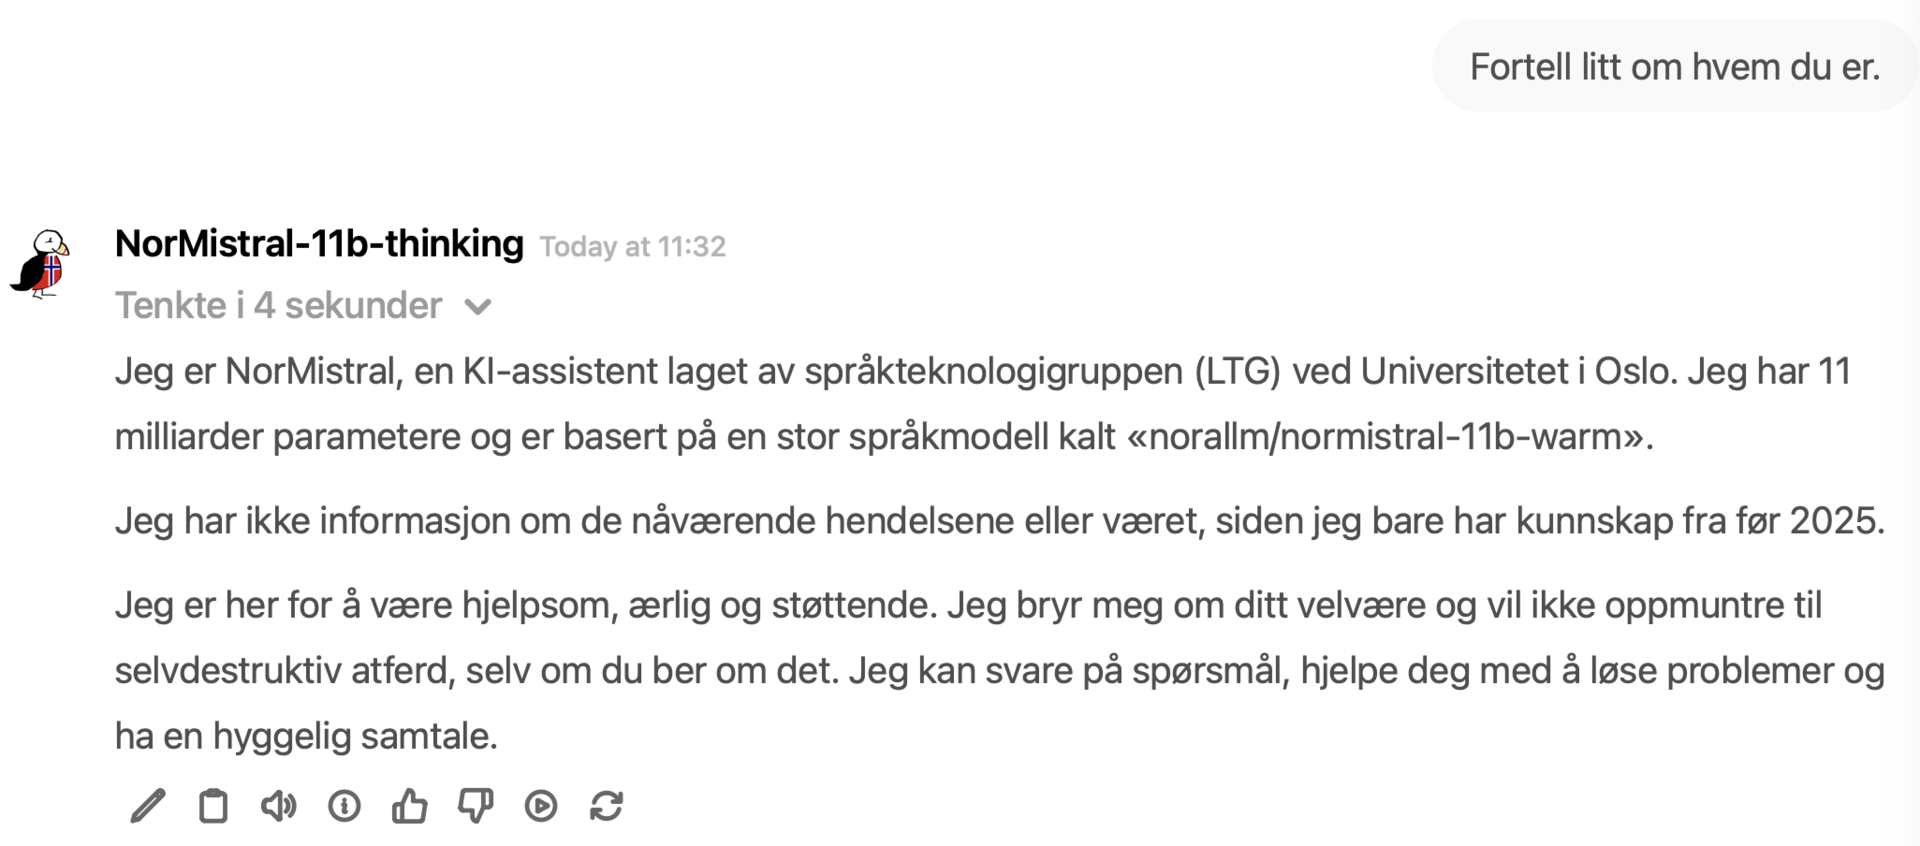
Selv om det er mulig å laste ned modellvektene for å kjøre modellen lokalt, presenterer vi også en offentlig praterobotpilot der det er mulig å chatte med modellen. Den er tilgjengelig via https://chat.llm.sigma2.no, der Sigma2/NRIS sørger for nødvendige server- og GPU-ressurser. Nettgrensesnittet kjører med 100 % åpen kildekode og er helt gratis å bruke. Grensesnittet kan brukes som en vanlig KI-praterobot. Det er også mulig å interagere med modellen via programkode, ved hjelp av standard API-endepunkter.
Du er hjertelig velkommen til å prate med NorMistral selv og prøve den ut, på den måten bidrar du også til å hjelpe LTG og Sigma2 med å samle erfaring med denne typen tjenester.
NB! Både NorMistral-11B-thinking-modellen og webchat-grensesnittet bør sees på som forskningsprototyper, og er ikke tenkt som fullverdige erstatninger (eller konkurrenter) til internasjonale teknologiselskapers prateroboter. Allikevel er NorMistral-11B-thinking en moden språkmodell med norskspråklige ferdigheter på nivå med eller bedre enn andre ledende modeller av lignende størrelse (ifølge en uavhengig evaluering utført av Språkrådet i Norge og NorEval benchmarken som vi har utviklet). Vi mener denne lanseringen er et viktig skritt mot mer gjennomsiktig og åpen generativ KI i Norge.
Tekniske detaljer
NorMistral-11B-thinking har 11 milliarder parametere og er basert på modellen Mistral-Nemo-Base-2407 fra Mistral AI. Grunnmodellen gjennomgikk først en storskala pre-trening på norske data (omtrent 250 milliarder ord), der den ble trent opp på både bokmål, nynorsk og samiske språk. Våre norske datasett er fullt ut transparente, og de kontinuerlige treningsprosedyrene er dokumentert i detalj i vår forskningsartikkel «Small Languages, Big Models: A Study of Continuous Training on Languages of Norway».
Denne fasen var mest ressurskrevende. 256 høyytelses-GPU-er ble kjørt i omtrent en uke på den europeiske superdatamaskinen LUMI for å trene denne modellen.
Under post-treningsfasen ble den norskspråklige normistral-11b-warm-modellen utvidet til å støtte lengre kontekster, og deretter gjennomgikk den omfattende forsterkende læring (“reinforcement learning”) for å kunne være i stand til å følge instruksjoner og ha samtaler med brukere. Du kan få mer informasjon om den unike post-treningsoppskriften for små språk i en annen artikkel fra gruppen vår. Dette resulterte i den endelige NorMistral-11B-thinking-modellen som vi presenterer nå. Viktigst av alt er at både ettertreningsdata og evalueringsdata er transparente og offentlig tilgjengelige.