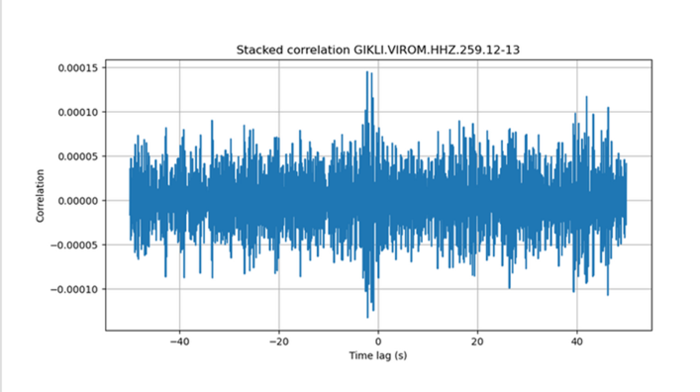
Seismografen ved Troll ble satt i drift i 2011 og har siden den gang samlet kontinuerlige tredimensjonale målinger. Dette gir et svært stort datasett. Oppgaven min er å bygge en katalog over seismiske hendelser fra hele driftsperioden ved hjelp av template‑matching. Prosessen er slik:
1. Filtrer dataen. Vi filtrerer ut de lave frekvensene (fjern‑jordskjelv) og de høyeste frekvensene (mest støy) for å beholde kun de relevante signalene
2. Se gjennom og velg en tydelig bølgeform
3. Lage en “template” av den bølgeformen
4. Kjør kode som søker gjennom hele datasettet og markerer liknende bølgeformer.
Ved hjelp av template-matching kan vi tolke seismisk data mye mer effektivt og automatisk identifisere selv svake, korte hendelser som ellers hadde blitt oversett.
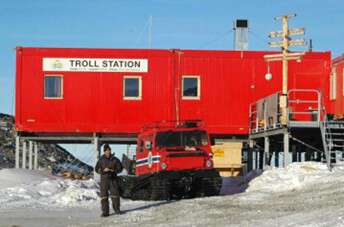
Neste steg for meg nå er å analysere resultatene av template-matchingen. Jeg vil fokusere på bølgeformene som gjentar seg mest og undersøke hvilke prosesser de kan representere. Ved å kartlegge kildene til de tilbakevendende signalene kan vi begynne å tolke hva de avslører om bevegelse og strukturen i kontinentet.